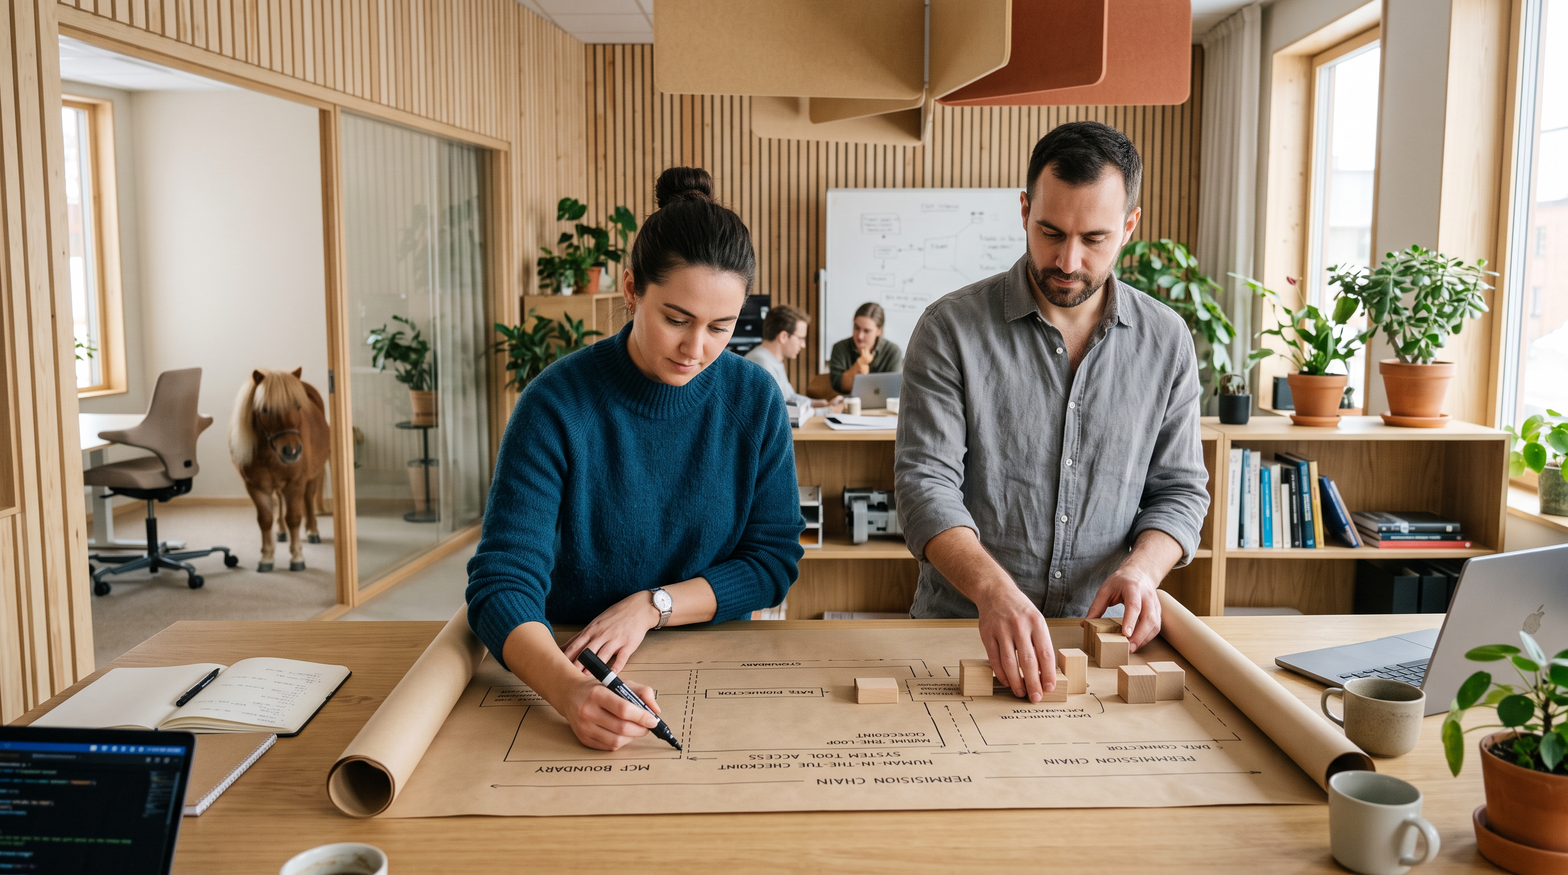
Vad MCP är, och varför det spelar roll
MCP står för Model Context Protocol. Det är ett standardiserat sätt för en AI-modell att använda verktyg och kopplas till andra system, oavsett vilken modell det är. Det är verktygen som gör en modell till en agent.
Standarden är praktisk, eftersom den ersätter en egen integration per system. Men den betyder också att en agents räckvidd bestäms av vilka MCP-servrar som kopplats på och vilka behörigheter de har.
Trycket att koppla på är stort, och säkerheten hänger inte alltid med. Studien "Exposed by Design" (juli 2026) testade 414 MCP-servrar som var nåbara från internet. 91,8 procent saknade OAuth-autentisering, och 687 verktyg som kan köra kommandon i skal var åtkomliga utan åtkomstkontroll. Dessutom försvann 41,6 procent av servrarna inom tre dagar, vilket tyder på snabba driftsättningar utan granskning. Studien är en preprint och mäter öppna servrar på internet, men den visar hur lätt det är att göra fel.
Gamla problem som blir tydligare: behörigheter
Mycket av det som kallas nya AI-risker är gamla behörighetsproblem som AI gör synliga.
Microsoft 365 Copilot svarar utifrån det användaren redan har tillgång till. Om filer och mappar delas för brett kan Copilot lyfta fram dem, trots att ingen avsåg det. Det som tidigare var svårt att hitta går nu att fråga efter. Microsoft har tagit fram en vägledning för att hantera "oversharing" före utrullning, med verktyg i Microsoft Purview och SharePoint Advanced Management.
Mönstret är bredare än Copilot. Enligt IBM:s Cost of a Data Breach 2026 saknade 92 procent av de organisationer som drabbats av ett AI-relaterat intrång ordentlig åtkomstkontroll för AI. Det är inte modellen som brister. Det är behörigheterna runt omkring den.
Nya sårbarheter: prompt injection, verktyg med för stor makt och skugg-AI
Prompt injection. En språkmodell skiljer inte mellan instruktion och data. Allt är text. Därför kan innehåll som agenten läser, till exempel ett mejl, en webbsida eller ett dokument, innehålla instruktioner som den följer. Brittiska NCSC skrev i december 2025 att prompt injection kanske aldrig går att eliminera helt, till skillnad från SQL-injektion. Rådet är att begränsa skadan snarare än att hoppas på ett filter, och att vara försiktig med leverantörer som lovar att "stoppa" prompt injection. Prompt injection är dessutom risk nummer ett i OWASP:s lista för LLM-applikationer.
Excessive agency. OWASP beskriver tre rötter till problemet: för mycket funktionalitet, för höga behörigheter och för stor självständighet. Deras exempel är lärorikt. En assistent som ska sammanfatta mejl får ett tillägg som också kan skicka mejl. Ett skadligt mejl instruerar assistenten att leta efter känslig information och vidarebefordra den. Lösningen är läsbehörighet i stället för skickbehörighet, och att en människa godkänner varje utskick.
Verktyg med högre rättigheter än användaren. Ett vanligt fel är att agentens koppling till ett system körs med ett generellt, privilegierat konto. Då kan en användare utan behörighet ändå nå uppgifter via verktyget. MCP:s egen vägledning varnar för just det: "confused deputy", där en betrodd komponent luras att använda sin makt åt någon annan.
Skugg-AI. Enligt IBM:s rapport för 2026 var skugg-AI inblandat i 43 procent av incidenterna, mot 20 procent året före. 68 procent av de drabbade saknade policy för AI-styrning. Skugg-AI är i grunden en synlighetsfråga: det går inte att skydda det ni inte vet finns.
Angripare och försvar: AI på båda sidor
Angripare använder AI, men inte som många tror. Mandiant skriver i M-Trends 2026 att 2025 inte var året då intrång direkt berodde på AI. De allra flesta lyckade intrång bottnade fortfarande i grundläggande mänskliga och systemmässiga brister. Samtidigt ser Mandiant skadlig kod som anropar språkmodeller under körning och som letar efter AI-verktyg på angripna datorer.
Försvaret har också något att vinna. IBM fann att tiden att identifiera och begränsa ett intrång 2025 var 241 dagar i genomsnitt, den lägsta på nio år, och kopplar det till AI-baserat försvar.
Men AI i försvaret bör inte stå ensamt. En modell som analyserar loggar läser också innehåll som en angripare kan ha påverkat, och kan då övertygas att allt är normalt. En människa som läser samma logg ser ofta direkt att något inte stämmer. NCSC:s råd gäller även här: bygg in spärrar som inte är beroende av att modellen gör rätt, och logga vad agenten faktiskt gör.
Så testar ni en agentkedja
Ett penetrationstest av AI behöver omfatta hela kedjan, inte bara modellen:
- Verktygen: vilka MCP-servrar finns, och vad kan agenten göra med dem?
- Behörigheterna: med vems identitet körs verktygen, och vad kan den identiteten nå?
- Godkännandena: var går gränsen för vad agenten får göra själv innan en människa måste godkänna?
- Indirekt prompt injection: vad händer när agenten läser innehåll som en angripare kan påverka?
Utgångspunkten är OWASP:s Top 10 för LLM-applikationer, där prompt injection och excessive agency är två av de viktigaste posterna.
AI-system förändras ofta, så ett test per år räcker sällan. Ta in testningen löpande i utvecklingen och testa om efter större förändringar. Och om ett system inte tål den kvarvarande risken kan det, som NCSC uttrycker det, vara ett olämpligt användningsområde för en språkmodell.
Fem frågor innan nästa agent kopplas in
- Vilka AI-verktyg och MCP-servrar används hos oss i dag, godkända eller inte?
- Med vems behörighet körs agentens verktyg, och är den mindre än användarens egen?
- Vilka åtgärder kräver att en människa godkänner innan de utförs?
- Är våra delade mappar och sajter städade innan vi låter en AI söka i dem?
- Loggar vi vad agenten gör, så att vi ser om något avviker?
Källor och tips på mer läsning
- NCSC: Prompt injection is not SQL injection (it may be worse), 8 december 2025
- OWASP GenAI: LLM06:2025 Excessive Agency
- OWASP GenAI: Top 10 för LLM-applikationer 2025
- Model Context Protocol: Security best practices
- Padilla: Exposed by Design, arXiv 2608.00150 (preprint, juli 2026)
- Microsoft Learn: Secure and govern Microsoft Copilot, deployment blueprint
- IBM: 2025 Cost of a Data Breach Report
- Baker Donelson: Ten takeaways from IBM:s Cost of a Data Breach 2026
- Mandiant M-Trends 2026, Google Cloud
Dela gärna detta på
Lucas Pettersson
Lucas Pettersson är konsult inom cybersäkerhet på Precio Fishbone. Han har en yrkesexamen som IT-säkerhetsspecialist och flera års erfarenhet av arbete med penetrationstester, kodgranskning, utredningar kopplade till cyberhot samt GRC-frågor (governance, risk och compliance). Lucas brinner för lösningar med stark kryptering och motiveras av att göra verklig skillnad – både för organisationers säkerhet och människors trygghet.